23:35 hrs. Aún no es demasiado tarde para pensar. Mientras me dedico a mi tesis doctoral, estoy creando una pequeña herramienta para modelar razonamientos jurídicos. Se trata de una herramienta de anotación, y esta herramienta me llevará a enfrentarme, con cierta fascinación, a un cuestionamiento existencial (o, al menos, existencial en lo que respecta a esta tesis). Esta cuestión va mucho más allá de mi ámbito de investigación.
Mi trabajo se basa en gran medida en lo que se denomina inteligencia artificial causal. En pocas palabras, con la mayoría de las herramientas de IA tradicionales, nos limitamos a hacer estadísticas. En ellas se modela el hecho de que dos cosas suelen ocurrir juntas (por ejemplo, las ventas de helados y las quemaduras solares aumentan al mismo tiempo en verano). Pero no se afirma que una cosa sea la causa de la otra, al menos no si queremos ser precisos. Con la IA causal, el objetivo es ir más allá: se busca establecer relaciones de causa y efecto. En resumen: se intenta trazar flechas en lugar de limitarse a constatar coincidencias.
Para ello, se utilizan algoritmos de descubrimiento causal.
Descubrimiento causal en datos jurídicos
El principio es el siguiente: se procesan amplias tablas de datos. En mi caso, las filas son miles de sentencias judiciales, y las columnas son conceptos jurídicos, marcados en su caso como presentes en el texto y, si es así, dónde exactamente.
A partir de ahí, se deduce matemáticamente una especie de mapa. Los conceptos son puntos (nodos), y una línea conecta aquellos que dependen unos de otros (arista). En otras palabras, con métodos avanzados, se busca calcular en unos segundos correlaciones que a un ser humano le llevarían meses desentrañar a mano.
Pero nos topamos con un límite. Con estos algoritmos, por lo general se consigue identificar que existe un vínculo entre dos conceptos. Sin embargo, resulta muy difícil extraer el significado. «A va con B» y «B va con A», vistos a través de una simple tabla de presencias, son idénticos como dos gotas de agua. El significado de las flechas permanece oculto desde este único prisma estadístico.
Para sortear este rompecabezas, me planteé una pregunta: ¿y si el orden en el que aparecen los conceptos en un texto permitiera deducir ese famoso significado? Lo que se escribe primero conduciría a lo que viene después. Si lo pensamos bien, no es tan descabellado, ya que así es como evoluciona un razonamiento. A menos que… quizá no.
Así que he desarrollado una pequeña interfaz en la que se muestra una sentencia real de la Suprema Corte de Justicia de México, con los conceptos resaltados. En ella, como jurista, trazo a mano las relaciones que realmente identifico al leerla, junto con su significado. La idea es luego comparar: ¿se corresponde mi hipótesis (el orden narrativo da el sentido causal) con las flechas trazadas por un experto?
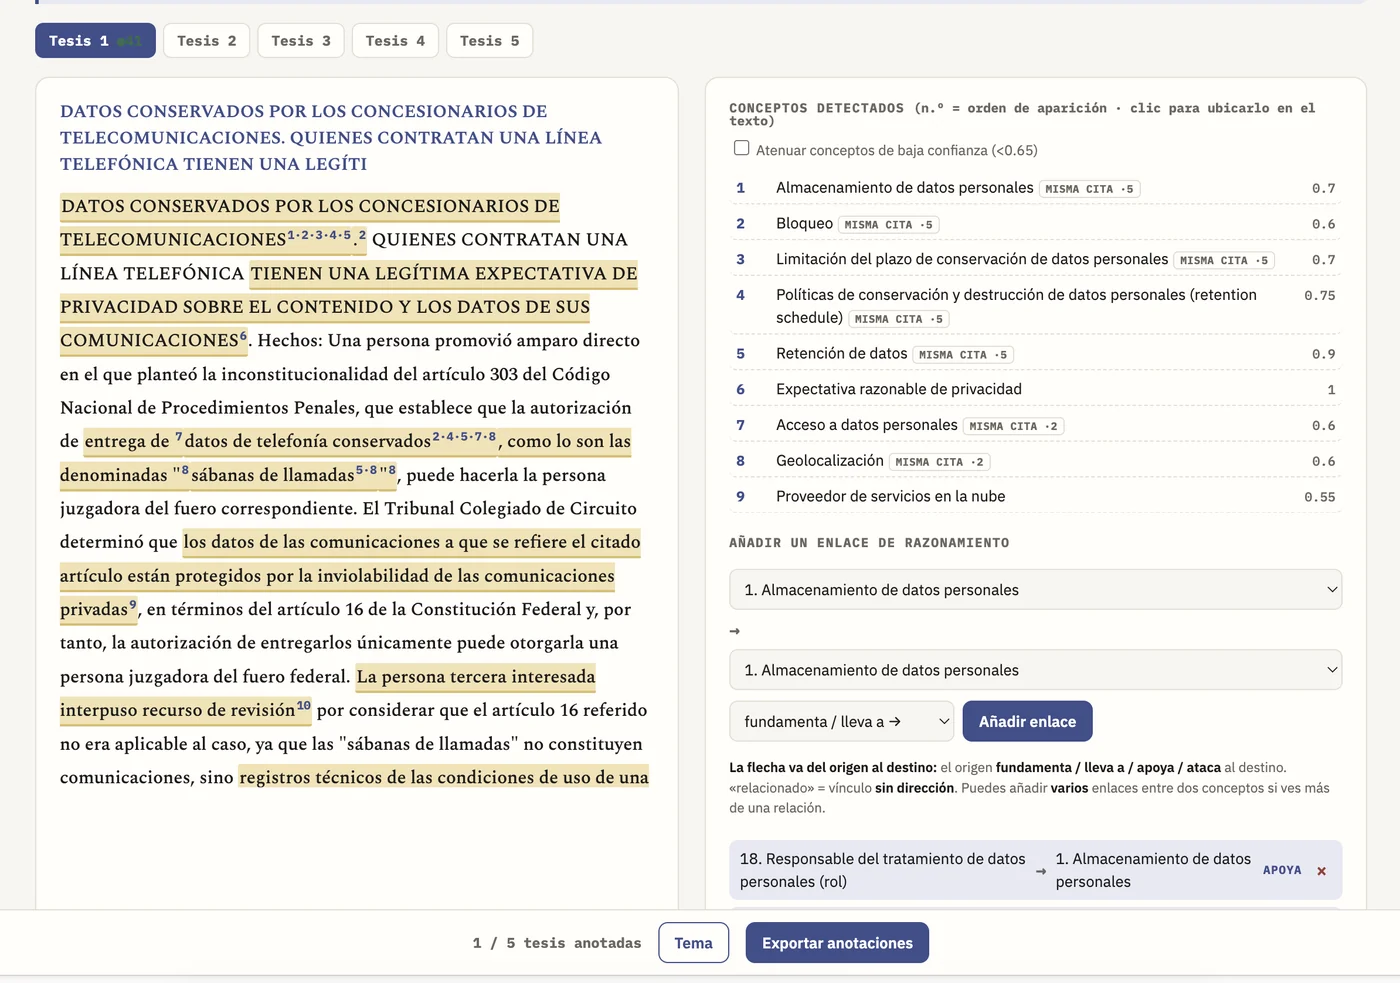
Y ahí es donde, al dibujar sobre esta sentencia real, me he topado con un obstáculo.
El razonamiento de un juez no encaja fácilmente en casillas
Para que el texto encaje en un grafo de razonamiento, tengo que pulir la sintaxis, eliminar matices. Y me doy cuenta de que lo que elimino suele ser valioso, incluso indispensable. Peor aún: me veo obligado a trazar un vínculo y su contrario.
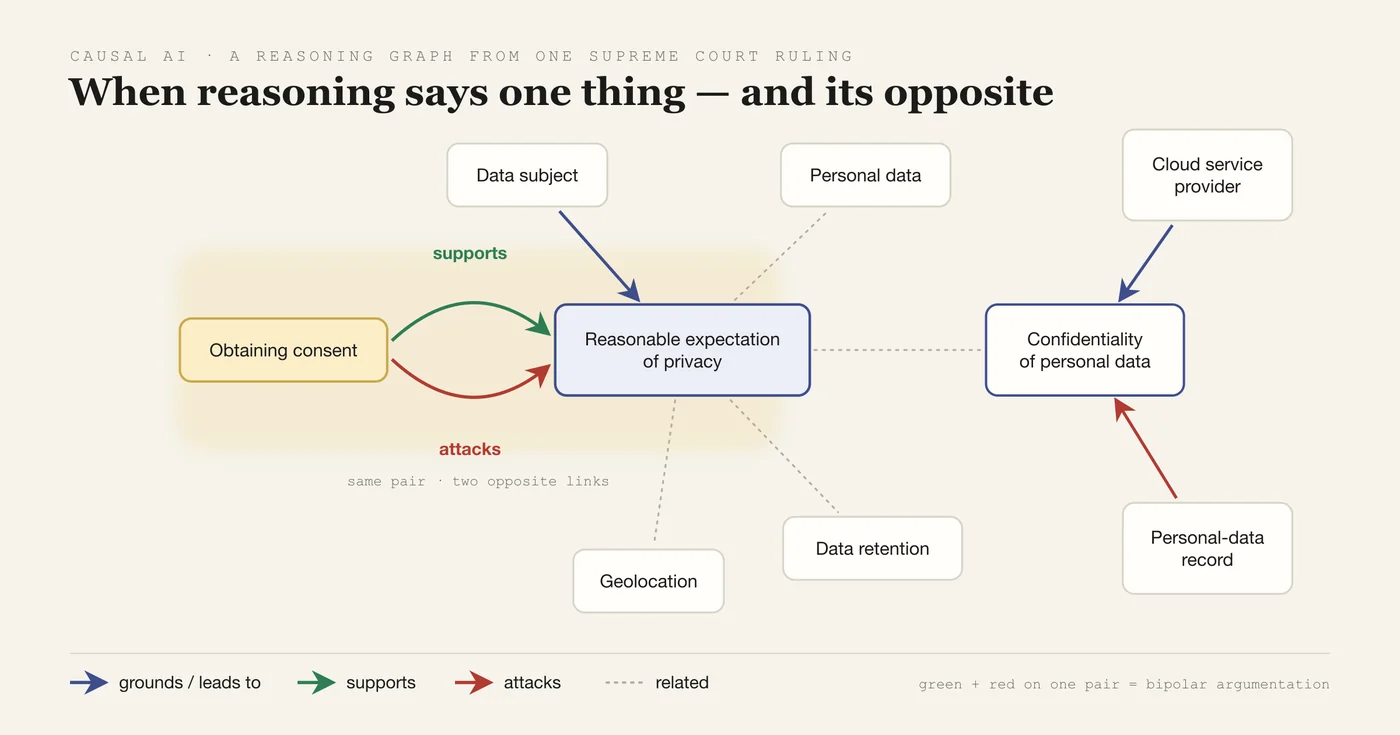
Parece absurdo en lógica matemática, pero es perfectamente habitual en el derecho. Un juez a menudo enuncia una doctrina para poder refutarla mejor. En la sentencia que estaba modelando, se empieza recordando una idea antigua: “al haber dado su consentimiento a un tercero, había cedido en su derecho a la privacidad.” Luego se invierte: “sin que dicha contratación constituya una autorización a los concesionarios y al Estado que destruya esa expectativa [de privacidad]”. En mi diagrama, esto se traduce en lo siguiente: el concepto A respalda el concepto B… y, unas líneas más adelante, ¡el mismo concepto A ataca al concepto B!
A esto se le llama argumentación bipolar. En un debate, un argumento puede hacer dos cosas: apoyar una idea o rechazarla (atacarla). Dos polos que coexisten. Decir una cosa y su contrario es una contradicción en la lógica clásica, pero en un texto es simplemente… el arte de razonar. Ahora bien, modelar estos dos polos sobre el mismo par de conceptos, en dos momentos diferentes, es exactamente lo que hace que un grafo sencillo se complique enormemente.
Esto me ha llevado a una reflexión bastante paradójica. Por supuesto, podría diseñar un grafo cronológico y argumentativo lo suficientemente rico como para captarlo todo: el orden, los apoyos, los ataques, los giros. Excepto que… ese grafo sería al menos tan complejo como el propio texto. Mi herramienta de modelización, que se supone que debe simplificar, se volvería tan enrevesada como aquello que representa. No es que contuviera más palabras, sino que habría que aprender a descifrar su gramática visual, mientras que un texto ya sabemos cómo interpretarlo.
Y ahí es donde se me ocurrió una pregunta. Si el mapa de un texto es tan rico y tan complejo de interpretar como el propio texto… entonces, ¿no es un texto escrito, con sus palabras, sus comas y su fluidez, ya, en sí mismo, el mejor de los grafos? Quizá el lenguaje humano sea el grafo más compacto que se haya inventado jamás, y yo me esfuerzo, con cierta ingenuidad, por redibujarlo con puntos y flechas. No sale bien. Vuelvo a empezar. Sísifo ya no está muy lejos…