23h35. Il n’est pas encore trop tard pour penser. Penché sur ma thèse de doctorat, je bricole un petit outil pour modéliser des raisonnements juridiques. C’est un outil d’annotation, et cet outil me fera me heurter, avec une certaine fascination, à un questionnement existentiel (à tout le moins, existentiel quant à cette thèse). Cette question dépasse largement mon coin de recherche.
Mon travail s’appuie beaucoup sur ce qu’on appelle l’intelligence artificielle causale. Pour faire simple, avec la plupart des outils d’IA traditionnels, on se contente de faire des statistiques. On y modélise le fait que deux choses arrivent souvent ensemble (par exemple, les ventes de glaces et les coups de soleil augmentent en même temps en été). Mais on ne dit pas que l’une cause l’autre, en tous cas pas si on veut être précis. Avec l’IA causale, l’objectif est d’aller plus loin : on cherche à établir des relations de cause à effet. Bref : on essaie de tracer des flèches au lieu de constater des coïncidences.
Pour cela, on utilise des algorithmes de découverte causale.
La découverte causale sur des données juridiques
Le principe est le suivant : on traite de vastes tableaux de données. Dans mon cas, mes lignes sont des milliers de décisions de justice, et mes colonnes sont des concepts juridiques, marqués éventuellement comme présents dans le texte et, si oui, où exactement.
On en déduit mathématiquement une sorte de carte. Les concepts sont des points (noeuds), et un trait relie ceux qui dépendent l’un de l’autre (arête). En d’autres termes, avec des méthodes avancées, on cherche à calculer en quelques secondes des corrélations qu’un humain mettrait des mois à démêler à la main.
Mais on se heurte à une limite. Avec ces algorithmes, on parvient en général à identifier qu’il y a un lien entre deux concepts. En revanche, on est bien en peine d’en extraire le sens. « A va avec B » et « B va avec A », vus au travers d’un simple tableau de présences, se ressemblent comme deux gouttes d’eau. Le sens des flèches reste invisible par ce seul prisme statistique.
Pour contourner ce casse-tête, je me suis posé une question : et si l’ordre dans lequel les concepts apparaissent dans un texte permettait de déduire ce fameux sens ? Ce qui est écrit d’abord mènerait à ce qui vient ensuite. Quand on y pense, ce n’est pas si bête, car c’est ainsi qu’évolue un raisonnement. À moins que… peut-être pas.
J’ai donc développé une petite interface où s’affiche un vrai arrêt de la Cour suprême du Mexique, avec les concepts surlignés. Dedans, en tant que juriste, je trace à la main les liens que j’identifie réellement à la lecture, avec leur sens. L’idée est ensuite de comparer : est-ce que mon hypothèse (l’ordre de narration donne le sens causal) correspond aux flèches tracées par un expert ?
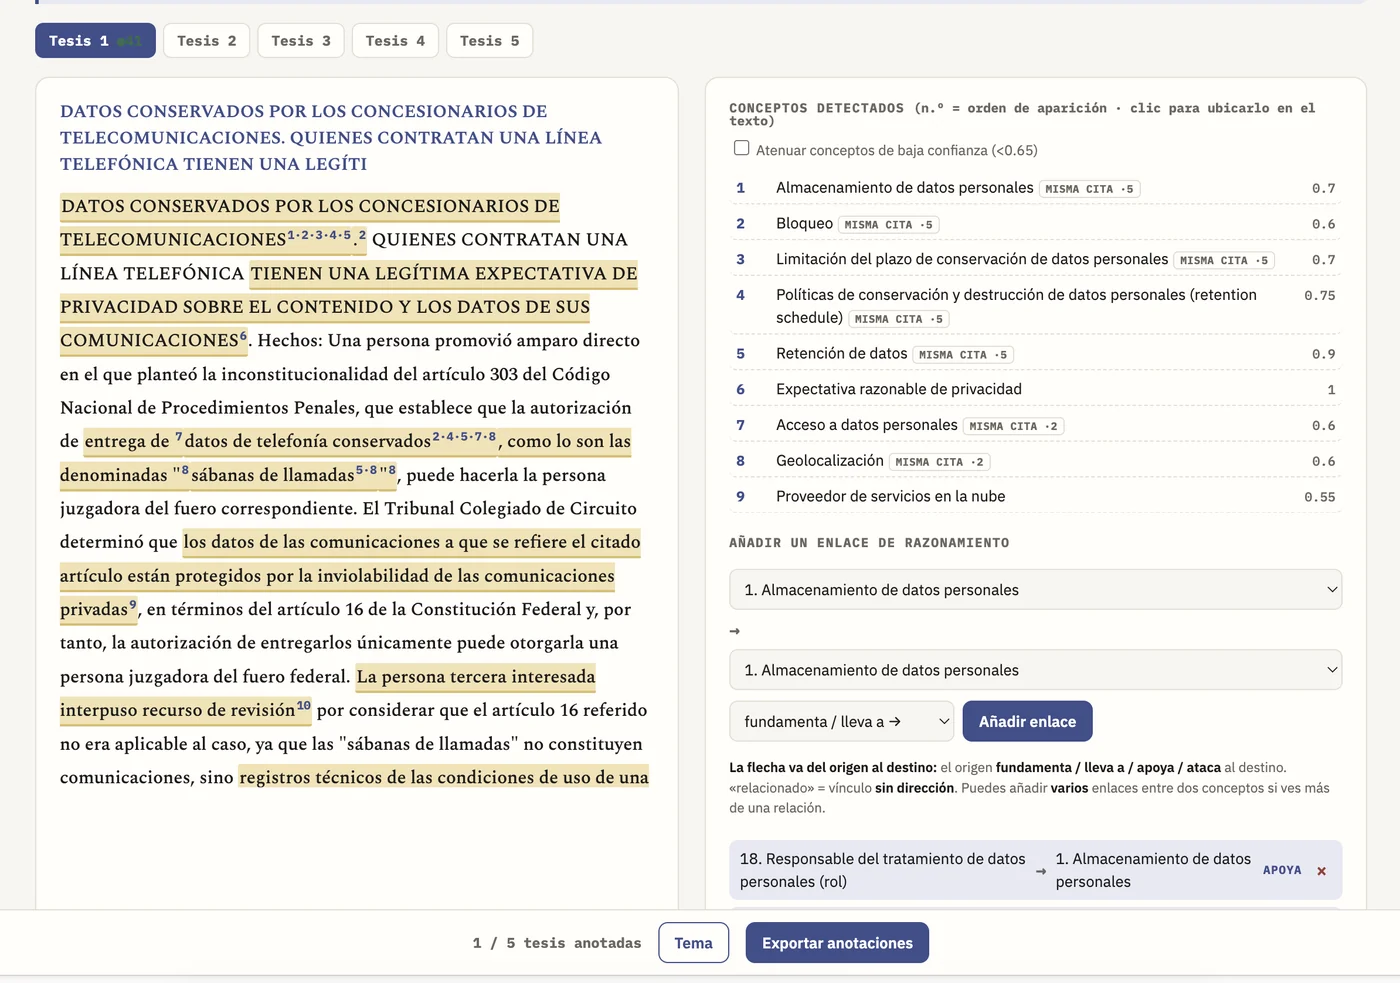
Et c’est là, en dessinant sur ce vrai arrêt, que j’ai buté.
Le raisonnement d’un juge ne rentre pas gentiment dans des cases
Pour faire tenir le texte dans un graphe de raisonnement, je dois raboter la syntaxe, supprimer des nuances. Et je m’aperçois que ce que j’ampute est souvent précieux, voire indispensable. Pire : je me retrouve à devoir tracer un lien et son contraire.
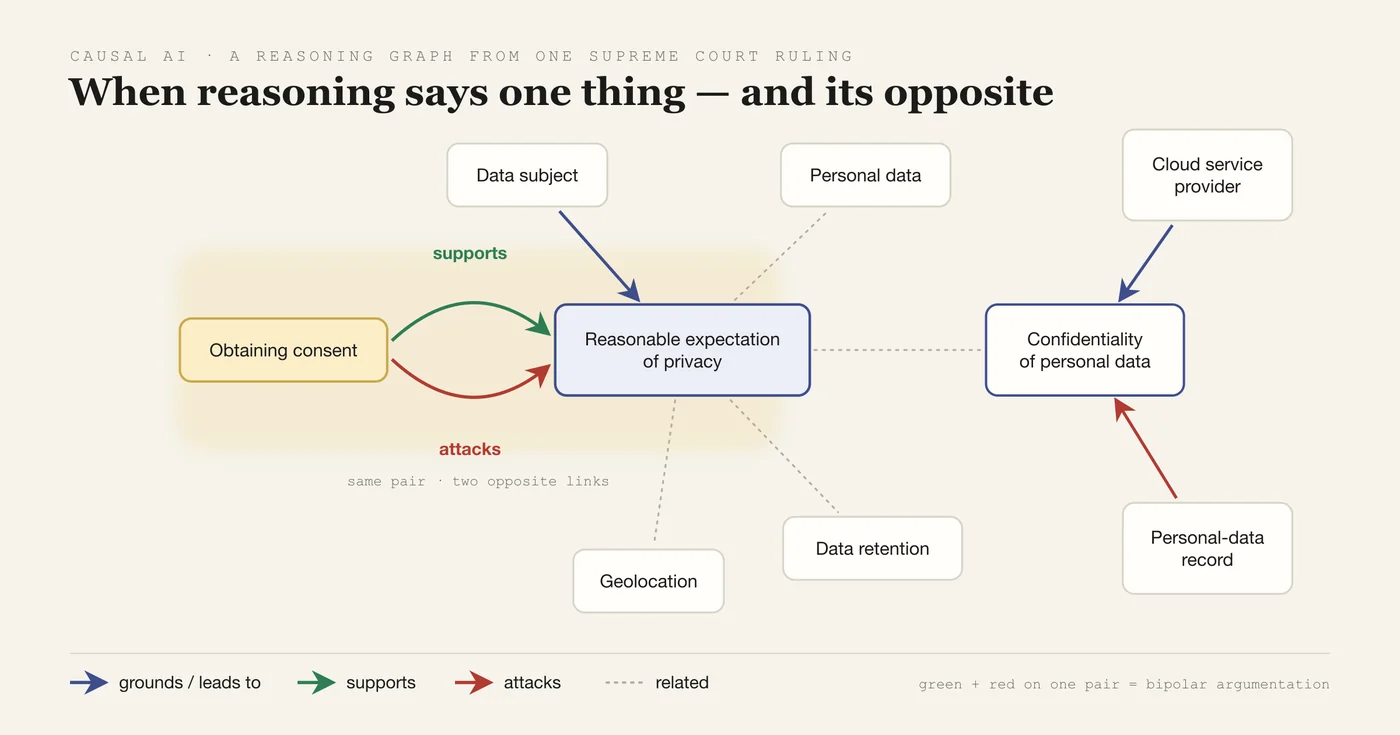
Ça a l’air absurde en logique mathématique, mais c’est parfaitement banal en droit. Un juge énonce souvent une doctrine pour mieux la démolir. Dans l’arrêt que je modélisais, on commence par rappeler une idée ancienne : « en confiant vos données à un opérateur, vous renoncez à votre vie privée ». Puis on la renverse : mais dans le contexte présent, non, vous gardez une attente légitime à la vie privée. Sur mon graphe, ça donne la chose suivante : le concept A soutient le concept B… puis, quelques lignes plus loin, le même concept A attaque le concept B !
C’est ce qu’on appelle l’argumentation bipolaire. Dans un débat, un argument peut faire deux choses : soutenir une idée, ou bien la rejeter (l’attaquer). Deux pôles qui coexistent. Dire une chose et son contraire est une contradiction en logique classique, mais dans un texte, c’est simplement… l’art de raisonner. Or, modéliser ces deux pôles sur la même paire de concepts, à deux moments différents, c’est exactement ce qui fait exploser un graphe simple.
Cela m’a mené à une réflexion plutôt paradoxale. Bien sûr, je pourrais concevoir un graphe chronologique et argumentatif assez riche pour tout capturer : l’ordre, les soutiens, les attaques, les revirements. Sauf que… ce graphe-là serait au moins aussi complexe que le texte lui-même. Mon outil de modélisation, censé simplifier, deviendrait aussi touffu que ce qu’il représente. Non pas qu’il contiendrait plus de mots, mais il faudrait apprendre à en déchiffrer la grammaire visuelle, alors qu’un texte, on sait déjà l’interpréter.
Et c’est là qu’une question m’est venue. Si la carte d’un texte est aussi riche, et aussi complexe à interpréter que le texte lui-même… alors un texte écrit, avec ses mots, ses virgules et sa fluidité, n’est-il pas déjà, en soi, le meilleur des graphes ? Peut-être que le langage humain est le graphe le plus compact que l’on ait jamais inventé, et je m’échine, un peu naïvement, à vouloir le redessiner avec des points et des flèches. Ça loupe. Je recommence. Sisyphe n’est plus très loin…